
Les organisations n’ont probablement jamais disposé d’autant de données.
Elles n’ont également jamais autant investi dans les plateformes analytiques, Power BI, le Cloud, l’automatisation, les architectures modernes de données et, plus récemment, l’intelligence artificielle.
Pourtant, derrière cette sophistication technologique subsiste une question beaucoup plus fondamentale :
Qui est réellement responsable de la donnée ?
Lorsqu’un indicateur diffère entre deux départements, qu’une définition métier varie d’une équipe à l’autre ou que plusieurs systèmes présentent des informations contradictoires, le problème n’est pas nécessairement technologique.
Il s’agit souvent d’un problème de gouvernance des données.
Et c’est précisément dans cet environnement que le rôle de Data Steward prend toute son importance.
Le Data Steward contribue à transformer les principes de gouvernance en pratiques concrètes : définitions communes, responsabilités claires, règles métier documentées, qualité mesurée et problèmes de données traités de manière structurée.
Comprendre ce métier devient essentiel pour toute organisation qui souhaite mieux exploiter ses données, améliorer ses décisions et préparer sérieusement ses initiatives en analytique et en intelligence artificielle.
Qu’est-ce qu’un Data Steward ?
Un Data Steward est une personne chargée de contribuer à la bonne gestion, à la compréhension, à la qualité et à l’utilisation appropriée des données d’une organisation.
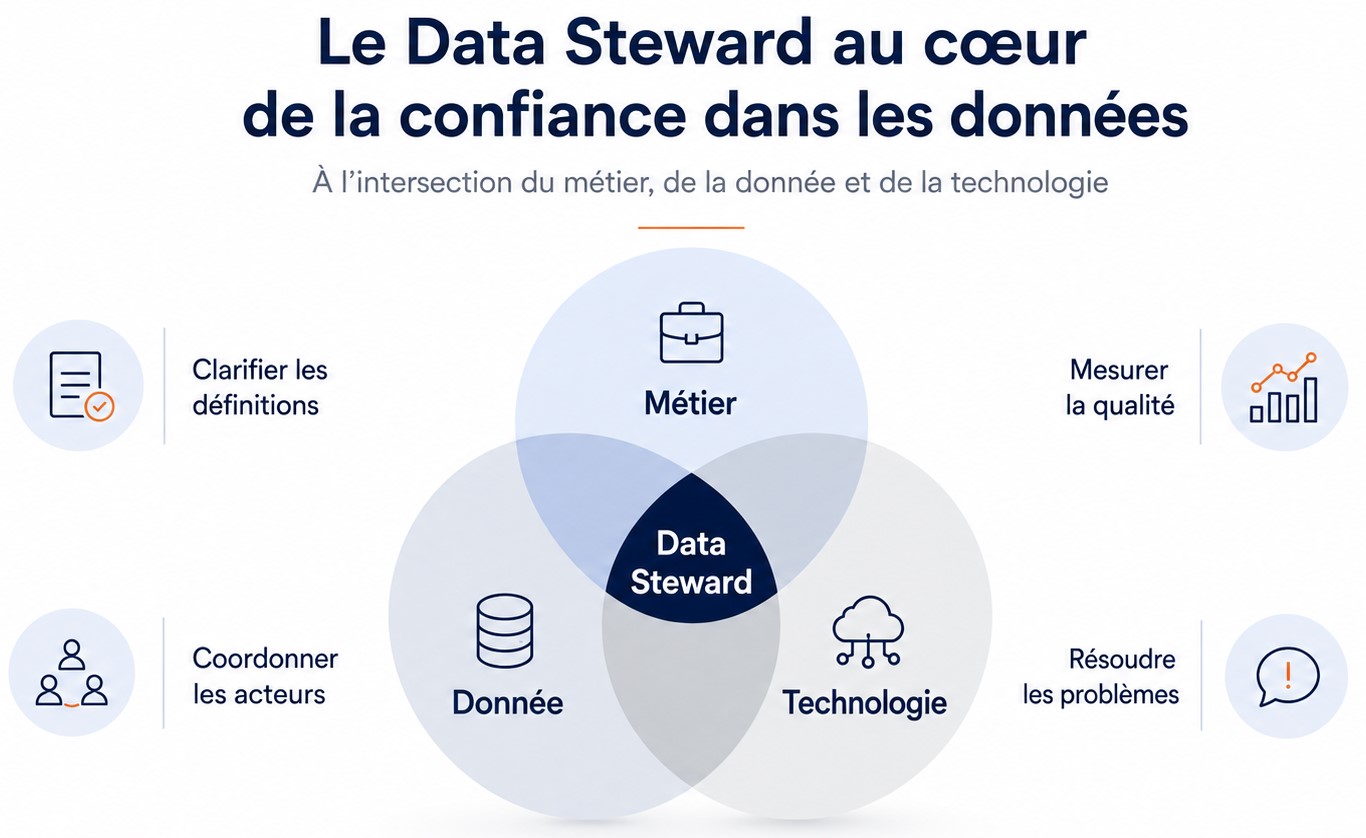
Il agit généralement à l’intersection de trois univers :
- le métier, qui comprend la signification et les usages de la donnée ;
- la donnée, qui doit être définie, documentée et contrôlée ;
- la technologie, qui permet de stocker, transformer, déplacer et exploiter cette donnée.
Le Data Steward n’est donc pas simplement une personne chargée de « nettoyer les données ».
Son rôle est beaucoup plus large.
Il peut notamment contribuer à :
- clarifier les définitions métier ;
- documenter les règles de gestion ;
- identifier les données critiques ;
- suivre la qualité des données ;
- documenter les métadonnées ;
- analyser les problèmes récurrents ;
- coordonner leur résolution ;
- maintenir un glossaire métier ;
- comprendre la provenance et les transformations de la donnée ;
- faciliter la collaboration entre les équipes métier et technologiques.
Le Data Steward devient ainsi un point de convergence autour de la donnée.
Pourquoi le rôle de Data Steward est-il devenu si important ?
Pendant longtemps, les organisations ont principalement cherché à collecter et à stocker les données.
Puis elles ont commencé à les centraliser dans des entrepôts de données et des plateformes analytiques.
Ensuite, avec des outils comme Power BI, elles ont démocratisé l’accès à l’information.
Aujourd’hui, elles souhaitent également utiliser leurs données pour alimenter des modèles d’intelligence artificielle, des copilotes, des assistants ou des automatisations avancées.
Cette démocratisation crée énormément de valeur.
Mais elle augmente également un risque : utiliser plus rapidement des données que l’organisation ne comprend pas suffisamment bien.
Imaginons une donnée apparemment simple :
Client actif
Cette notion peut pourtant signifier plusieurs choses.
Un client actif est-il :
- un client ayant effectué une transaction dans les 12 derniers mois ?
- un client possédant un contrat actif ?
- un client qui n’a pas demandé la fermeture de son compte ?
- un client ayant une facture en cours ?
- un client apparaissant comme actif dans le CRM ?
Chaque définition peut être parfaitement logique.
Le problème apparaît lorsque plusieurs équipes utilisent des définitions différentes pour produire des rapports présentés comme comparables.
La donnée devient alors techniquement disponible, mais organisationnellement ambiguë.
C’est précisément ce type de problème que le Data Stewardship cherche à prévenir.
Data Governance et Data Stewardship : quelle différence ?

Les termes Data Governance et Data Stewardship sont souvent utilisés comme s’ils étaient interchangeables.
Ils ne le sont pas.
Ils représentent deux dimensions complémentaires de la gestion des données.
La Data Governance définit le cadre
La gouvernance des données établit les principes, les responsabilités et les mécanismes de décision relatifs aux données.
Elle cherche notamment à déterminer :
- qui possède l’autorité sur certaines données ;
- quelles règles doivent être respectées ;
- comment les responsabilités sont distribuées ;
- comment les décisions sont prises ;
- comment les conflits sont arbitrés ;
- quels domaines de données doivent être prioritaires ;
- comment les risques sont gérés.
La gouvernance définit donc essentiellement les règles du jeu.
Le Data Stewardship fait vivre ce cadre
Le Data Stewardship traduit ces principes dans les opérations quotidiennes.
Il consiste par exemple à :
- maintenir les définitions ;
- documenter les règles métier ;
- surveiller les indicateurs de qualité ;
- comprendre les anomalies ;
- coordonner les équipes impliquées ;
- maintenir la documentation ;
- suivre les problèmes de données ;
- faire appliquer les décisions prises dans le cadre de la gouvernance.
Une distinction simple permet de retenir la différence :
La Data Governance établit le cadre. Le Data Stewardship permet de le faire vivre au quotidien.
Une organisation peut donc disposer d’une politique de gouvernance très complète tout en continuant à souffrir de problèmes importants de qualité ou de cohérence.
La raison est simple : une politique seule ne modifie pas les comportements, les définitions ni les processus.
Il faut des acteurs chargés de transformer ces principes en réalité opérationnelle.
Data Owner et Data Steward : qui fait quoi ?

Une autre confusion fréquente concerne les rôles de Data Owner et de Data Steward.
Ils sont complémentaires, mais leurs responsabilités ne sont pas identiques.
Le Data Owner
Le Data Owner possède généralement l’autorité métier sur un domaine de données.
Il peut être responsable de décisions telles que :
- approuver une définition importante ;
- arbitrer un désaccord entre plusieurs équipes ;
- accepter ou refuser un niveau de risque ;
- déterminer les priorités ;
- approuver certains usages ;
- soutenir les investissements nécessaires à l’amélioration des données.
Le Data Owner se situe donc davantage au niveau de la responsabilité et de la décision.
Le Data Steward
Le Data Steward est généralement plus proche du fonctionnement quotidien.
Il contribue à :
- documenter les données ;
- maintenir leurs définitions ;
- suivre leur qualité ;
- identifier les anomalies ;
- analyser les causes ;
- coordonner les intervenants ;
- assurer le suivi des corrections.
On peut résumer la relation de la manière suivante :
Le Data Owner décide et arbitre. Le Data Steward structure, surveille et coordonne.
Cette distinction est importante, car une gouvernance efficace nécessite à la fois une autorité décisionnelle et une capacité opérationnelle.
Le Data Steward n’est pas le propriétaire du système informatique
L’un des pièges les plus fréquents consiste à confondre la responsabilité de la donnée avec la responsabilité du système qui la contient.
Une équipe technologique peut parfaitement savoir :
- dans quelle base de données se trouve une information ;
- dans quelle table elle est stockée ;
- comment elle est transférée ;
- quelles transformations sont effectuées ;
- quelles applications la consomment.
Mais cela ne signifie pas nécessairement que cette équipe est la mieux placée pour décider de la signification métier de cette donnée.
Prenons un champ appelé :
Date_Fermeture_Dossier
L’équipe technologique sait peut-être précisément où se trouve cette colonne.
Mais le métier doit déterminer ce que signifie « fermeture ».
Est-ce :
- la date de décision ?
- la date de notification au client ?
- la date de la dernière action administrative ?
- la date à laquelle le dossier devient officiellement inactif ?
Le rôle du Data Steward est justement de créer le pont entre ces dimensions techniques et métier.
Toutes les données n’ont pas besoin du même niveau de gouvernance

Une erreur fréquente dans les programmes de gouvernance consiste à vouloir gouverner immédiatement toutes les données de l’organisation.
Dans un environnement moderne, cela peut représenter :
- des centaines d’applications ;
- des milliers de tables ;
- des dizaines de milliers de colonnes ;
- des millions d’enregistrements.
Essayer de documenter l’ensemble dès le départ est rarement réaliste.
Une approche plus efficace consiste à identifier d’abord les données critiques.
On parle parfois de Critical Data Elements.
Il s’agit des données dont une erreur pourrait avoir un impact important sur :
- une décision stratégique ;
- un processus opérationnel ;
- un client ;
- une transaction ;
- une obligation réglementaire ;
- un résultat financier ;
- un indicateur de performance ;
- un modèle analytique.
La question à poser n’est donc pas :
« Combien de données pouvons-nous documenter ? »
Mais plutôt :
« Quelles sont les données dont nous devons absolument pouvoir garantir la compréhension et la fiabilité ? »
Cette approche permet de concentrer les efforts là où ils créent réellement de la valeur.
Bonne pratique 1 : construire un glossaire métier
La première étape d’une bonne gouvernance consiste souvent à créer un langage commun.
C’est le rôle du Business Glossary, ou glossaire métier.
Un bon glossaire ne se limite pas à une liste de termes.
Pour une donnée importante, il devrait progressivement permettre de comprendre :
- son nom métier ;
- sa définition ;
- son Data Owner ;
- son Data Steward ;
- sa source de référence ;
- ses règles métier ;
- son mode de calcul ;
- ses principaux usages ;
- son niveau de confidentialité ;
- les rapports ou indicateurs qui en dépendent.
Prenons l’indicateur :
Revenu annuel
Sa définition semble évidente.
Mais plusieurs questions apparaissent rapidement :
Inclut-il les taxes ?
Les remboursements sont-ils déduits ?
Les revenus sont-ils reconnus à la facturation ou au paiement ?
Quelle devise est utilisée ?
Sur quelle période ?
Les transactions annulées sont-elles exclues ?
Sans réponse commune, deux tableaux de bord peuvent afficher des résultats différents tout en étant techniquement corrects.
Le glossaire métier permet précisément de réduire cette ambiguïté.
Bonne pratique 2 : mesurer la qualité des données

Dire qu’une donnée est « de bonne qualité » n’est pas suffisant.
La qualité doit pouvoir être mesurée.
Plusieurs dimensions sont généralement utilisées.
Complétude
Les informations attendues sont-elles présentes ?
Par exemple :
98 % des dossiers possèdent une adresse complète.
Validité
La donnée respecte-t-elle les règles attendues ?
Par exemple :
une date de naissance ne peut pas être située dans le futur.
Cohérence
Les informations sont-elles compatibles entre elles ?
Par exemple :
un dossier indiqué comme « fermé » devrait normalement posséder une date de fermeture.
Exactitude
La valeur correspond-elle réellement à la réalité ?
Cette dimension est souvent plus complexe à mesurer puisqu’elle nécessite une référence fiable.
Actualité
La donnée est-elle suffisamment récente pour son utilisation ?
Une adresse correcte il y a trois ans n’est pas nécessairement encore utilisable aujourd’hui.
Unicité
Une même entité apparaît-elle plusieurs fois alors qu’elle devrait être unique ?
Les doublons de clients constituent un exemple classique.
La qualité des données doit être mesurée selon l’usage

Il existe néanmoins un principe encore plus important que les dimensions elles-mêmes :
La qualité d’une donnée dépend de son usage.
Une précision de 90 % peut être parfaitement acceptable pour une analyse exploratoire.
Elle peut être totalement insuffisante pour :
- produire un rapport financier ;
- effectuer un paiement ;
- respecter une obligation réglementaire ;
- calculer une rémunération ;
- entraîner un système automatisé critique.
L’objectif du Data Stewardship n’est donc pas nécessairement d’atteindre 100 % de qualité partout.
Il consiste à déterminer :
quel niveau de qualité est nécessaire pour quel usage.
C’est un changement important de perspective.
La qualité des données devient alors un sujet de gestion du risque et de valeur métier, plutôt qu’une simple activité technique.
Bonne pratique 3 : documenter et traiter les problèmes de données
Dans beaucoup d’organisations, les problèmes de données sont encore traités de façon informelle.
Un analyste constate une anomalie.
Il envoie un message à un collègue.
Une correction ponctuelle est effectuée.
Puis le même problème réapparaît quelques semaines plus tard.
Une approche plus mature consiste à gérer les problèmes de données comme un véritable processus.
Un problème significatif devrait idéalement être :
- identifié ;
- documenté ;
- évalué ;
- assigné ;
- analysé ;
- corrigé ;
- validé ;
- clôturé.
Cette discipline permet également de conserver une trace des décisions prises.
Avec le temps, l’organisation peut alors identifier :
- les problèmes récurrents ;
- les systèmes les plus concernés ;
- les processus les plus fragiles ;
- les données présentant le plus de risques ;
- les coûts générés par la mauvaise qualité.
La gouvernance devient ainsi mesurable.
Bonne pratique 4 : rechercher la cause racine
Supposons qu’une organisation détecte 10 000 adresses incorrectement formatées.
Une première approche consiste à nettoyer les 10 000 enregistrements.
Cette correction peut être nécessaire.
Mais elle ne règle pas nécessairement le problème.
Le Data Steward doit également poser la question :
Pourquoi ces erreurs sont-elles apparues ?
Peut-être que :
- le formulaire ne possède aucune validation ;
- plusieurs formats sont autorisés ;
- un ancien système génère des erreurs ;
- une interface transforme incorrectement les données ;
- un processus manuel crée régulièrement des anomalies.
Corriger les données existantes traite le stock.
Corriger le processus qui crée les erreurs traite le flux.
Les organisations matures doivent faire les deux.
Dans le cas contraire, elles accumulent progressivement une forme de Data Debt : une dette de données constituée de problèmes connus mais jamais véritablement éliminés.
Bonne pratique 5 : rendre les responsabilités explicites
Lorsqu’un problème de données survient, une question permet souvent d’évaluer rapidement la maturité d’une organisation :
« Qui est responsable ? »
Si la réponse est :
« Cela dépend. »
« Probablement TI. »
« Demandez peut-être aux finances. »
« Je pense que quelqu’un s’en occupe. »
… la gouvernance repose probablement encore largement sur des relations informelles.
Pour chaque donnée réellement critique, une organisation devrait progressivement pouvoir identifier :
- son Data Owner ;
- son Data Steward ;
- son système de référence ;
- ses principaux utilisateurs ;
- les règles métier qui s’appliquent ;
- son niveau de qualité attendu ;
- les responsables à contacter en cas de problème.
Cette clarification réduit considérablement les zones grises organisationnelles.
Bonne pratique 6 : comprendre le data lineage
Une donnée ne reste généralement pas dans le système où elle a été créée.
Elle peut être :
- saisie dans une application ;
- transférée vers une autre plateforme ;
- transformée ;
- enrichie ;
- stockée dans un entrepôt ;
- agrégée ;
- utilisée dans Power BI ;
- transmise à une application ;
- exploitée par un modèle d’intelligence artificielle.
Comprendre ce parcours constitue le data lineage, ou traçabilité des données.
Le Data Steward n’a pas nécessairement besoin de maîtriser chaque détail technique.
Mais il devrait pouvoir comprendre quatre éléments fondamentaux :
D’où vient la donnée ?
Quelles transformations subit-elle ?
Où est-elle utilisée ?
Quelles conséquences aurait une modification ?
Cette compréhension devient particulièrement importante dans des environnements où les données alimentent plusieurs rapports, applications et modèles analytiques.
Data Stewardship et Power BI
La gouvernance des données est particulièrement importante dans les environnements Power BI.
Power BI permet aux organisations de démocratiser rapidement l’accès aux données.
Mais cette démocratisation soulève également plusieurs questions.
Par exemple :
- Quelle source doit être utilisée pour produire un indicateur ?
- Quelle définition du revenu est officielle ?
- Quel modèle sémantique constitue la référence ?
- Qui peut créer une nouvelle mesure ?
- Comment éviter plusieurs versions du même KPI ?
- Comment s’assurer que les données utilisées sont suffisamment fiables ?
Un environnement Power BI mature ne repose donc pas uniquement sur de bons modèles techniques.
Il repose également sur une gouvernance claire de la sémantique des données.
Les Data Stewards peuvent alors jouer un rôle important dans la définition des concepts métier utilisés dans les modèles, les indicateurs et les tableaux de bord.
Pourquoi l’intelligence artificielle rend le Data Stewardship encore plus important
L’intelligence artificielle ne réduit pas le besoin de gouvernance des données.
Elle l’augmente.
Les organisations souhaitent aujourd’hui créer :
- des assistants internes ;
- des copilotes ;
- des systèmes RAG ;
- des modèles prédictifs ;
- des automatisations intelligentes ;
- des outils capables d’interroger directement les données de l’entreprise.
Mais une intelligence artificielle ne peut pas automatiquement résoudre une ambiguïté organisationnelle.
Si plusieurs départements utilisent différentes définitions d’un même indicateur, l’IA hérite de cette ambiguïté.
Si les sources sont contradictoires, elle hérite de cette contradiction.
Si les données sont mal classifiées, le risque de sécurité augmente.
Si personne ne possède la responsabilité d’un domaine de données, la résolution des erreurs devient complexe.
Avant de parler uniquement de modèles d’IA, les organisations doivent donc également répondre à des questions fondamentales :
- Quelles sont nos sources de référence ?
- Quelles données sont fiables ?
- Qui en est responsable ?
- Comment sont-elles définies ?
- Quels usages sont autorisés ?
- Quelle est leur provenance ?
L’IA rend ainsi la gouvernance des données beaucoup plus stratégique.
À quoi ressemble une organisation mature en Data Stewardship ?
Une organisation n’a pas besoin d’un programme extrêmement complexe pour commencer à progresser.
Elle devrait toutefois pouvoir répondre progressivement à quelques questions simples concernant ses données les plus importantes.
Savons-nous ce qu’elles signifient ?
Savons-nous qui en est responsable ?
Savons-nous d’où elles proviennent ?
Savons-nous où elles sont utilisées ?
Avons-nous défini un niveau de qualité attendu ?
Mesurons-nous cette qualité ?
Savons-nous quoi faire lorsqu’un problème apparaît ?
Conservons-nous la trace des décisions prises ?
Plus une organisation peut répondre clairement à ces questions, plus sa gouvernance devient concrète.
Par où commencer ?
La mise en place du Data Stewardship ne nécessite pas nécessairement de lancer immédiatement un programme à grande échelle.
Une démarche pragmatique peut commencer par quelques étapes.
1. Choisir un domaine métier prioritaire
Par exemple :
clients, fournisseurs, ventes, finances ou ressources humaines.
2. Identifier les données critiques
Sélectionner une vingtaine de données ou indicateurs réellement importants.
3. Identifier les responsabilités
Pour chacune :
- Data Owner ;
- Data Steward ;
- source de référence.
4. Documenter les définitions
Créer progressivement un glossaire métier.
5. Définir quelques règles de qualité
Ne pas chercher à tout mesurer.
Commencer par les contrôles ayant le plus d’impact.
6. Mettre en place un processus de gestion des problèmes
Documenter, prioriser, assigner et suivre les anomalies importantes.
7. Mesurer les progrès
Quelques indicateurs peuvent suffire :
- taux de complétude ;
- nombre de problèmes ouverts ;
- délai moyen de résolution ;
- pourcentage de données critiques documentées ;
- nombre de règles de qualité opérationnelles.
Cette approche progressive produit généralement davantage de valeur qu’un programme de gouvernance trop ambitieux dès son lancement.
Les principales erreurs à éviter
Commencer par acheter un outil
Un catalogue de données, une plateforme de gouvernance ou un outil de Data Quality peut apporter énormément de valeur.
Mais un outil ne peut pas décider à la place de l’organisation :
- qui possède une donnée ;
- quelle définition doit être utilisée ;
- quel niveau de qualité est acceptable ;
- qui doit arbitrer un désaccord.
La technologie doit soutenir la gouvernance, pas tenter de la remplacer.
Nommer des Data Stewards sans préciser leur mandat
Le titre seul ne suffit pas.
Il faut définir :
- leur périmètre ;
- leurs responsabilités ;
- leur capacité d’escalade ;
- leurs interactions avec les Data Owners ;
- le temps réellement consacré au rôle.
Chercher à gouverner toutes les données
La gouvernance doit être proportionnelle à la valeur et au risque.
Il est souvent préférable de gouverner correctement 25 éléments de données critiques plutôt que de documenter superficiellement 25 000 colonnes.
Transformer la gouvernance en bureaucratie
La gouvernance doit faciliter la prise de décision et améliorer la confiance.
Si elle produit uniquement des réunions, des documents et des validations supplémentaires, elle risque rapidement d’être perçue comme un obstacle.
Une bonne gouvernance doit rester proportionnée, pragmatique et orientée valeur.
En conclusion : le Data Steward organise la confiance dans les données
Les organisations ont progressivement appris à stocker leurs données, à les centraliser, à les visualiser et maintenant à les exploiter avec l’intelligence artificielle.
Mais une question reste fondamentale :
Peut-on réellement faire confiance aux données utilisées pour prendre nos décisions ?
Cette confiance ne provient pas uniquement d’une architecture moderne ou d’un nouvel outil.
Elle repose sur un ensemble cohérent de :
- responsabilités ;
- définitions ;
- règles ;
- contrôles ;
- mesures ;
- processus ;
- collaboration.
C’est précisément la raison d’être du Data Stewardship.
Le Data Steward contribue à transformer une donnée technique en un actif organisationnel compris, gouverné et exploitable.
Et dans un contexte où les organisations souhaitent démocratiser Power BI, automatiser davantage leurs processus et accélérer l’adoption de l’intelligence artificielle, ce rôle devient de plus en plus stratégique.
La question à poser n’est donc peut-être plus seulement :
« Avons-nous suffisamment de données ? »
Mais plutôt :
« Pour nos données les plus importantes, savons-nous ce qu’elles signifient, qui en est responsable et si nous pouvons réellement leur faire confiance ? »
C’est souvent à partir de cette question que commence une véritable gouvernance des données.
Besoin d’accompagnement en gouvernance des données, Power BI ou Data Strategy ?
PowerBIQC accompagne les organisations dans la structuration et l’exploitation de leurs données : Power BI, gouvernance des données, qualité des données, Power Platform, automatisation et intelligence artificielle appliquée.
L’objectif : transformer la donnée en information fiable, compréhensible et réellement utile à la prise de décision.
Contactez PowerBIQC pour discuter de vos enjeux de données, de gouvernance ou d’analytique.


Leave a Reply